はじめに
こんにちは。クラウドインテグレーション部 クラウドソリューション3課の青木です。
普段の仕事でLLMを使っていても、スクリプトやジョブに組み込んでいる方は多くないのではないでしょうか。組み込もうとすると、速度・費用・出力形式が壁になります。この記事では、その壁を越えるために作られた判断特化のAI「Jev」を紹介します。Jevが文章を書かない理由と得意・不得意を整理し、if文・LLMとの使い分けと組み合わせ方を説明します。
この記事は、2026年10月8日に、弊社主催のオンライン勉強会『話題の「Jev」は、なぜ文章を書かないのか ― 判断特化AIの使いどころ』で登壇した際の発表内容をまとめたものです。記事中の数値や仕様は、勉強会の前日にあたる2026年10月7日時点の情報です。それ以降の動きは、「他社の判断特化モデル」の節に追記しています。
LLMをスクリプトから呼びにくい3つの理由
LLMをスクリプトやジョブから呼ぼうとすると、次の3つが壁になります。
- 1回の処理に数秒〜数十秒かかり、リアルタイムの処理に向かない
- 呼んだ回数だけ従量課金が積み上がる
- 返答が文章なので、プログラムで使うにはパースが必要
3つ目を例で説明します。たとえば問い合わせが返金の依頼かどうかを知りたいだけでも、LLMは返事を文章で返します。その文章を解析して値に変換しないと、プログラムのif文には渡せません。JSON形式で返させる機能もありますが、1トークンずつ生成する仕組みは同じなので、速度と費用の課題は残ります。
文章を書かないAI「Jev」
Jevは、TypeSafe AI社が2026年9月に発表したモデルです。返すのは、型の決まった判断とその確率だけです。出力を読むのは人間ではなく、プログラムです。
TypeSafe AI社は、Jevのようなモデルを「System Oneモデル」と呼んでいます。名前の由来は、心理学でいう「速い思考(System 1)」と「遅い思考(System 2)」です。「これは〇〇の話だな」と一瞬で下す判断がSystem 1、規約を調べて返信を書くような作業がSystem 2にあたります。Jevは前者を担い、人なら数秒で下せる狭い判断を0.1秒前後でプログラムに返します。
従来のLLMとの違いは、次のとおりです。
| 観点 | 従来のLLM | Jev |
|---|---|---|
| 出力 | 長文テキスト | 型定義された判断結果 |
| 出力を読むもの | 人間 | プログラム(コード) |
| 答えの出し方 | 1トークンずつ順番に書く | 全部の答えを1回で並列に出す |
| 自信の度合い | 根拠なく過信しがち | 確率どおりに当たるよう調整 |
自信の度合いは、確率として返ってきます。TypeSafe AI社によると、確率0.8と返した答えは、約8割の確率で当たるように調整されています。1つ1つの答えを保証するものではなく、多くの答えをまとめて見たときの割合です。
ざっくり言うと、Jevは「デジタルマークシート」です。
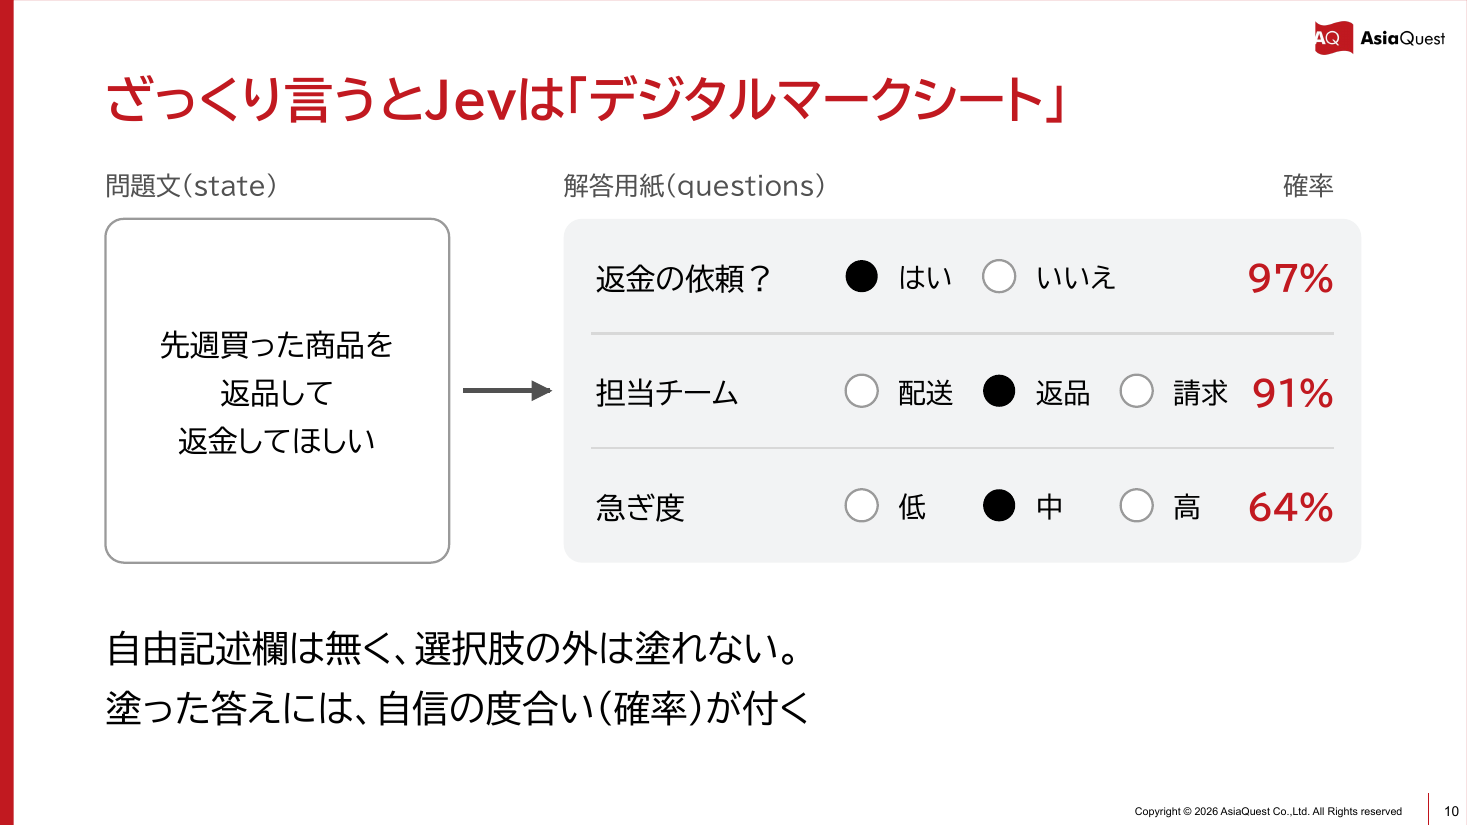
左の文章を読んで、右の解答用紙の選択肢を1つずつ塗っていきます。マークシートなので自由記述欄はなく、用意された選択肢の外は塗れません。そのかわり、塗った答えには確率が付きます。
Jevが文章を書かない3つの理由
1つ目は、人ではなくプログラムのためのAIだからです。型の決まった値で返ってくれば、パースせずにそのままif文へ渡せます。
2つ目は、速さと費用です。LLMは文章を1トークンずつ生成するので、長く書くほど時間も費用もかかります。Jevは数値を返すだけなので、0.1秒前後で終わります。
3つ目は、選択肢にない答えを作り出さないことです。答えは必ず、用意した選択肢のどれかになります。ただし、選ぶ答えを誤ることはあるので、後述する確信度を使って扱います。
Jevが文章を書かないのは手抜きではなく、プログラムから毎回呼ぶための設計です。
公式サイトの比較では速度が約75倍、費用は約1/170
TypeSafe AI公式サイトには、同じ処理をJevと一般的なLLMで1回ずつ実行したデモの数値が載っています。比較対象のLLMの名前は公表されていません。
| 項目 | Jev | 一般的なLLM |
|---|---|---|
| 1回の処理にかかる時間 | 0.114秒 | 8.566秒 |
| 1,000回処理したときの費用 | $0.081 | $13.88 |
このデモ1回分の数値から計算すると、速度は約75倍、費用は約1/170です。なお、公式サイトの見出しでは、System Oneタスク全体を想定した別の倍率をうたっています。料金と性能の主な仕様は、次のとおりです。
| 項目 | jev-1.13.0(10月7日時点のjev-latest) |
|---|---|
| 料金 | 入力 $0.042 / 100万トークン(出力は無料) |
| レイテンシ | 70〜500ms |
| 入力制限 | テキストのみ、最大64kトークン |
出力が無料なのは、返すのが数値だけだからです。この価格と速度なら、毎分動くバッチやループ処理の中でも、毎回呼ぶことが現実的になります。
APIの書き方と使うコツ
問い合わせのメッセージが返金を求めているかを判定する例です。渡すのは、判定したい対象を入れる state と、聞きたいことを入れる questions の2つです。
{
    "model": "jev-latest",
    "state": {
        "message": "先週買った商品を返品して返金してほしい"
    },
    "questions": {
        "is_refund_request": {
            "type": "noul",
            "instructions": "`message` が返金を求めているか判定する"
        }
    }
}
返ってくるのは、確率だけです。
{
    "answers": {
        "is_refund_request": {
            "type": "noul",
            "noul": 0.97
        }
    }
}
プログラム側では、たとえば値が0.8より大きければ返金の窓口に回す、といったif文でそのまま使えます。
質問の型は、次の3つです。
| 型(type) | 質問のタイプ | 返ってくるもの |
|---|---|---|
| noul | 二者択一(Yes / No) | 真である確率(0.0〜1.0) |
| choice | 単一選択(最大255択) | 選ばれた選択肢、確信度、選択肢ごとの確率 |
| score | 段階評価(最大10段階) | 確率で重み付けしたスコア(小数になることもある)、確信度、段階ごとの確率 |
質問は1回のリクエストにまとめる
Jevは、各質問を独立して並列に判定します。そのため、質問を増やしてもレイテンシはほとんど変わりません。
公式のクックブック「Parallel questions」では、13問を1回にまとめた場合と、1問ずつ13回送った場合を比べています。まとめたほうが12.2倍安く、10倍速くなり、答えの内容は変わりませんでした。細かく何度も送るより、1回にまとめるほうがJevに向いています。
確信度で処理を分岐する
choice と score には確信度が付くので、これを使って後続の処理を分けます。noul の場合は、返ってくる確率そのものを使います。
- 確信度が高い:そのまま自動で後続の処理を実行する
- 確信度が中くらい:人間による確認を挟む
- 確信度が低い:人間のオペレーターに渡す
しきい値は、操作のリスクに合わせて決めます。ログを見るだけのような安全な操作なら緩めに、ファイルやデータを更新する操作なら厳しめに設定する、といった調整が重要です。
Jevの使われ方
ブラウザ操作:Jev Ultrafast
Jev Ultrafastは、Browser UseのチームがGitHubで公開しているブラウザ操作のエージェントです。公式のデモでは、Google Flightsでチューリッヒからロンドンへの便を探す一連の操作を、7.1秒で終えています。
仕組みは単純です。画面のボタンや入力欄などのHTML要素を、番号付きのリストにして state に渡します。
[1] button     Change ticket type · Round trip
[2] combobox   Where from?        · San Francisco
[3] combobox   Where to?          · empty
[4] textbox    Departure          · empty
Jevは、どの操作をどの番号の要素に行うかを選ぶだけです。文字の入力が必要な場面だけ、軽量なLLMに任せます。選択肢から選ぶ作りなので、画面にないボタンを押すような誤動作は起きません。
音声エージェント
音声での応答は、速さが求められる用途です。会話の間が空くと、不自然になったりストレスを感じたりします。
第三者がGitHubで公開しているベンチマーク「jev-benchmarks」の音声エージェントの検証では、会話の1ターンごとに4つの状態を判定させています。会話の意図、話し終わったか、人に代わるべきか、緊急度の4つです。この判定にかかった時間の中央値は、Jevが159ms、最速クラスのLLM(GPT-5.6 Luna)が1,086msでした。
ただし、意図を読み取る精度はLLMのほうが高いです。そこで、確信度が低いときは「少々お待ちください」とつないで、Claudeなどの大型LLMに判断させる組み合わせ方があります。
Jevにできないこと・苦手なこと
ここまで読むと、全部Jevに置き換えればよいと思うかもしれません。ですが、Jevには仕様上できないことがあります。
- 文章の生成(要約、翻訳、レポート作成など)
- 画像・音声・動画などの直接の読み込み
- 定義された選択肢にない、自由な文字列での回答
- ファイルの編集や、シェルコマンドの直接の実行
なお、画像の入力は、10月14日に公開されたJev 1.14で試験的に提供されています。詳しくは、後述の追記を参照してください。
文章が要る仕事は、これまでどおりLLMに任せます。画像や音声を扱うなら、事前にテキストへ変換する仕組みが別に必要です。候補の一覧を作りたいなら、その一覧は前段のコードで作ってから渡します。
できるけれど、精度が落ちることもあります。これらは、公式ドキュメントの制約に関するページ「Jev 1.13 jaggedness」にも、はっきり書かれています。
- 数値の厳密な計算、件数のカウント、日付・時刻の比較
- 関係のないノイズが多い長文(ログの丸投げなど)
- 入力データに仕込まれた悪意のある指示(プロンプトインジェクション)
- 二重否定や、多段階のロジックが必要な推論
計算や比較は、先にコードで済ませてから渡します。ログを渡すなら、先にgrepなどで絞り込むと精度が上がりやすくなります。複雑な条件は質問を細かく分け、組み立ての部分はコードやLLMに任せます。
もう1つ重要なのが、日本語の精度です。公式ドキュメントのモデルのページによると、主な学習言語は英語で、精度が最も高いのも英語です。日本語も扱えますが、英語ほどの精度は出ません。本番で使う前に、自社の業務データで試してしきい値を調整する必要があります。
if文・LLM・Jevの使い分け
どれを使うかは、3つの問いで切り分けられます。
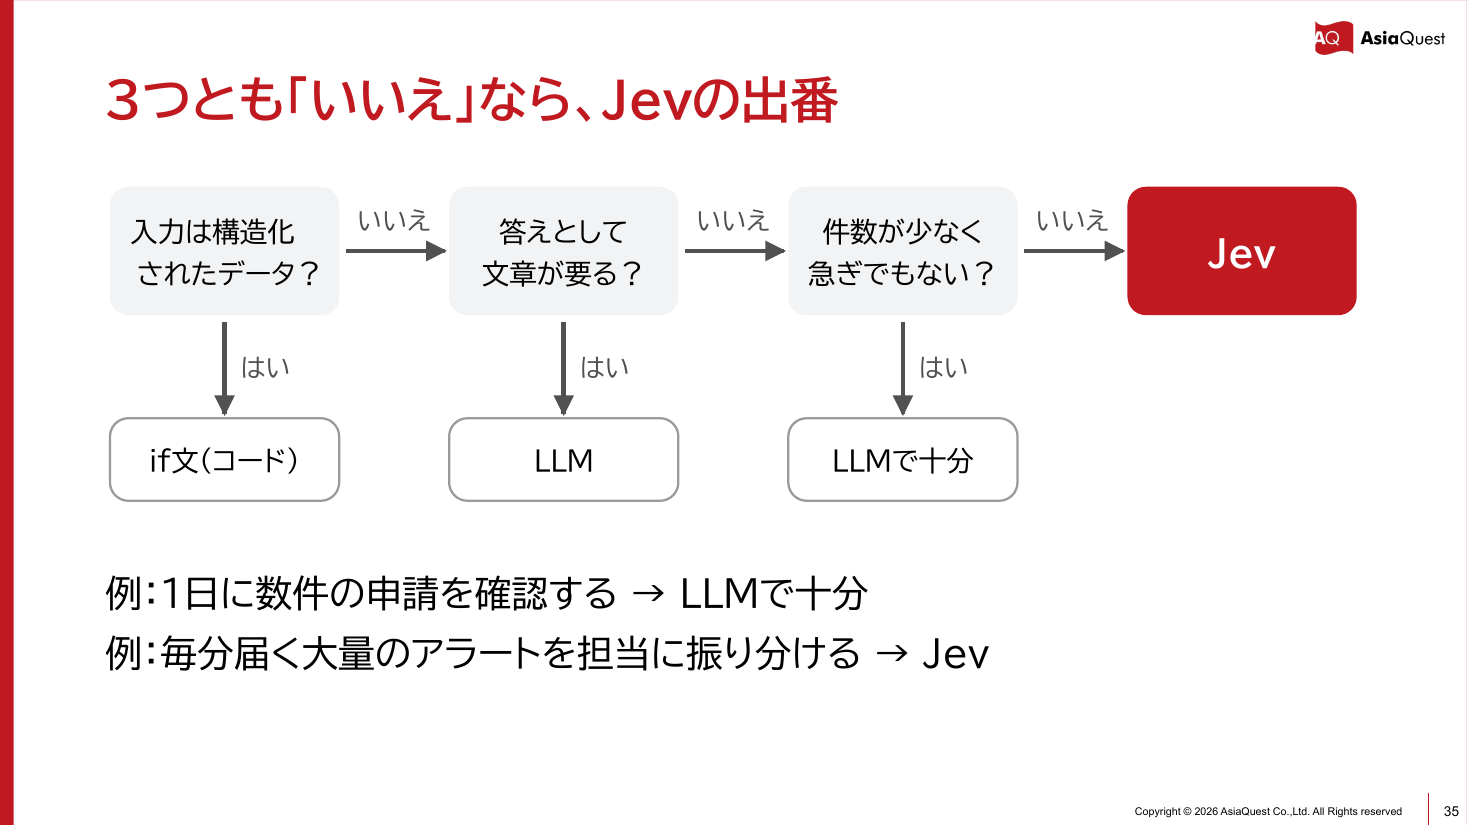
1つ目は、入力が構造化されたデータかどうかです。CPU使用率が90%を超えたら通知する、といった判断は数値とルールで決まるので、if文で書けます。AIは要りません。
2つ目は、答えとして文章が要るかどうかです。問い合わせへの返信や障害報告の要約のように、答えそのものが文章ならLLMに書かせます。
3つ目は、件数が少なく急ぎでもないかどうかです。1日に数件の申請を確認する程度なら、1回に数秒かかっても困りませんし、費用もわずかです。精度もLLMのほうが高いので、LLMで十分です。
3つとも「いいえ」なら、Jevの出番です。毎分届く大量のアラートを担当に振り分ける処理のように、文章を読んで選択肢から選ぶ判断を、大量にすぐ行いたい場面です。
具体的な業務に当てはめると、次のように分かれます。
| 業務 | Jevに向いている | Jevに向いていない |
|---|---|---|
| 監視 | アラート本文から担当を振り分け | CPU使用率などのしきい値判定(if文で十分) |
| コマンド実行 | 実行前のコマンドの危険度判定 | 実行ログの件数・時間の集計(コードで計算) |
| 変更管理 | 変更申請のリスクを5段階で評価 | 変更報告書や要約の作成(LLMが得意) |
大型LLMとの組み合わせ方
JevはLLMを置き換えるものではなく、組み合わせて使うものです。よく使われそうなパターンを3つ紹介します。
パターン1:判定はJev、回答の作成はClaude
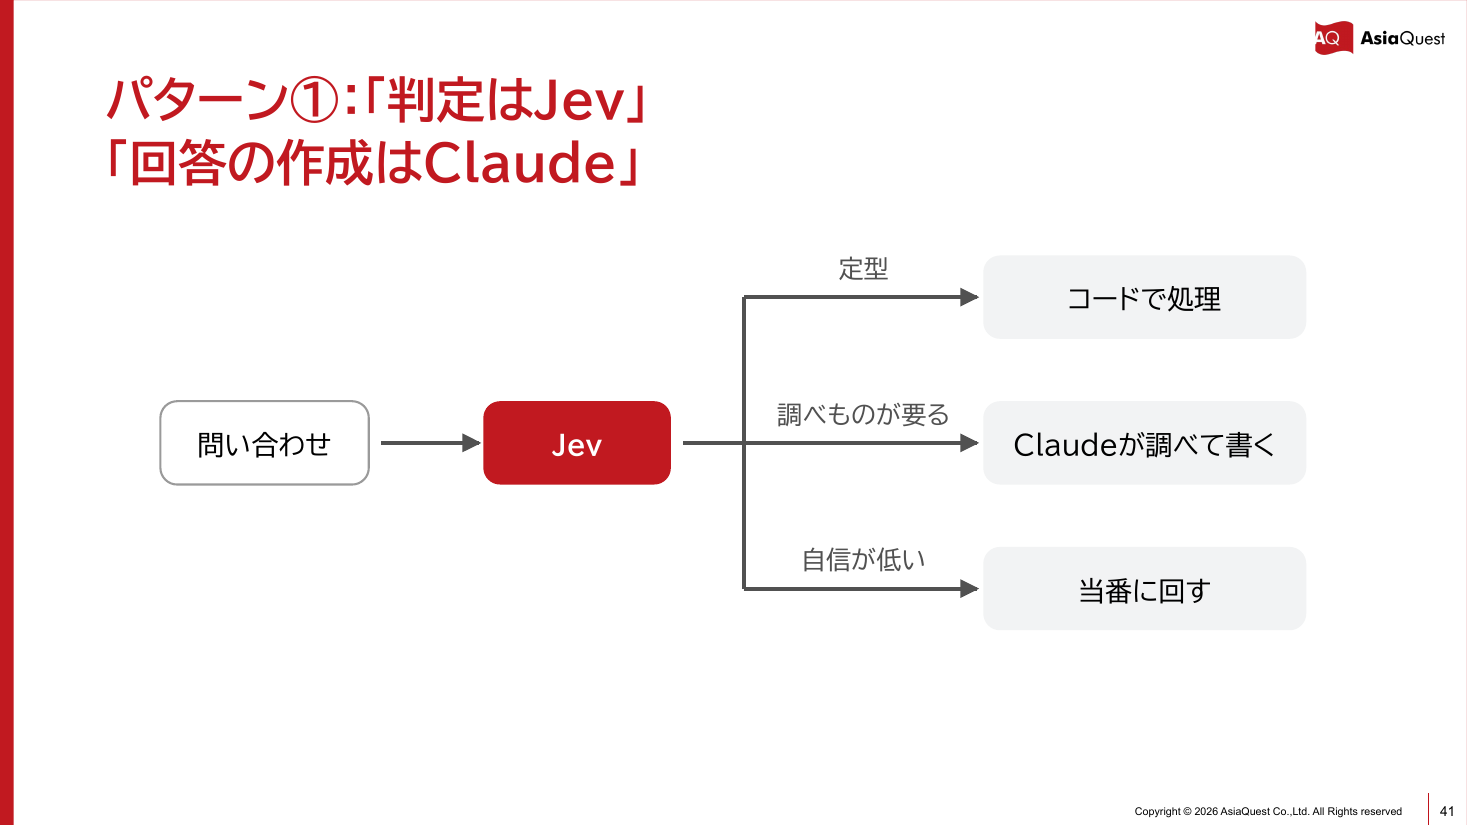
問い合わせが来たら、まずJevが振り分けます。定型ならコードですぐに処理し、調べものが要るならClaudeに回し、自信がなければ人間の当番に回します。
全件をClaudeに回すと、毎回数秒かかり、費用もかさみます。前段にJevを挟むことで、全体が速くなり、コストも抑えられます。最も使いやすい形になりそうです。
パターン2:確信度が低い案件だけ大型LLMに回す
同じく第三者によるベンチマーク「jev-benchmarks」では、問い合わせ分類で、全件をLLMで処理する構成と、Jevで判定して確信度が0.8未満のものだけLLMに回す構成を比べています。LLMには、大型のGPT-6 Astraと軽量のGPT-5.6 Lunaの2種類を使っています。データは、銀行の問い合わせを77種類に分類するBanking77です。
| 構成 | 全体の正解率 | 平均応答時間(1件あたり) | コスト(1,000件あたり) |
|---|---|---|---|
| 大型LLM(GPT-6 Astra)単体で全件処理 | 86.7% | 2.8秒 | $5.70 |
| Jevで判定し、迷ったら大型LLM | 85.3% | 1.0秒 | $1.56 |
| 軽量LLM(GPT-5.6 Luna)単体で全件処理 | 85.3% | 1.3秒 | $0.12 |
| Jevで判定し、迷ったら軽量LLM | 84.0% | 0.6秒 | $0.08 |
Jevと大型LLMを組み合わせた構成では、全体の76%をJevだけで処理し、残りの24%を大型LLMに引き継ぎました。正解率はほとんど変わらず、コストは$5.70から$1.56に、平均応答時間は2.8秒から1.0秒に下がっています。
ただし、軽量なGPT-5.6 Luna単体で全件を処理しても、正解率85.3%・$0.12でした。コストを下げる効果の多くは、大型LLMを軽量なモデルに替えることで得られます。軽量LLMにJevを組み合わせても、コストは$0.12から$0.08に下がる程度です。一方で、平均応答時間は1.3秒から0.6秒と、およそ半分になります。軽量LLMと比べたときのJevの利点は、主に応答時間です。
パターン3:Claude Codeのガードレールとして挟む
逆に、AIエージェントの見張り役としてJevを使う方法もあります。GitHubで公開されているjev-harnessは、Claude CodeやCodexのフックにJevの判定を挟むプラグインです。Claude Codeが「タスク完了」と判断したタイミングでは、Stop フックで完了の主張が実行記録と合っているかをJevに判定させ、足りなければ差し戻します。
完了時だけでなく、実行前にも確認します。ファイルの書き込みやシェルコマンドの実行前に、PreToolUse フックで計画が審査済みか、範囲内の操作かを判定します。条件を満たさない操作は、実行前に拒否されます。
jev-harnessのREADMEで紹介されている実測(autopoiesys、2026年9月)では、同じ判定をLLMのサブエージェントにさせると、1回あたり42K〜128Kトークンかかりました。Jevなら1回500〜2,500トークンで済むので、毎ターン挟んでも低コストです。
他社の判断特化モデル
Jevのような判断特化のモデルは、ほかの会社からも出ています。
OpenAIのDecisions APIとの比較(2026年10月7日時点)
ここでは、勉強会で比較したOpenAIのDecisions APIを取り上げます。
Decisions APIは、2026年9月29日のDevDayで発表され、10月6日にベータ版が公開されました。低価格モデルのGPT-6 Lunaが、Jevと同じく確率付きで判断を返します。OpenAIによると、Responses API経由でGPT-6 Lunaを呼ぶより、最大10倍速く判断を返します。
| 観点 | Jev | Decisions API |
|---|---|---|
| 質問の型 | noul / choice / score | predicate / choice / score |
| 確率・確信度 | あり | あり |
| 入力 | テキストのみ | テキスト・画像 |
| 料金(入力) | $0.042 / 100万トークン | $0.10 / 100万トークン |
| 速度(公称) | 70〜500ms | Responses API経由のLunaより最大10倍速い |
| 提供状況 | 公開中 | ベータ(10月6日〜) |
型の名前は違いますが、「質問の型」と「確率・確信度」はほぼ同じです。大きく違うのは、入力と料金です。速度はどちらも公称値で、同じ条件で比べたものではありません。
問い合わせの文章やログのように、テキストだけで判断できるならJevを選びます。入力の料金が半分以下だからです。画面のスクリーンショットなど、画像を見せて判断させたいなら、画像を渡せるDecisions APIのほうが簡単です。
2026年10月27日時点の状況(追記)
この項は、記事の公開にあたって最新の情報に更新したものです。勉強会の当日にはお話ししていない内容です。
勉強会のあとも、判断特化のモデルは各社から続けて登場しています。2026年10月27日時点で、主なものを並べると次のとおりです。
| 観点 | Jev | Decisions API | Microsoft-Decision-1 | Strands Decider 2B |
|---|---|---|---|---|
| 提供元 | TypeSafe AI | OpenAI(Azure OpenAIでも提供) | Microsoft | AWS(Strands Labs) |
| 公開日・状態 | 9月15日に公開、10月14日に1.14 | 10月22日に正式版 | 10月9日にプレビュー | 10月1日にOSSとして公開 |
| 提供形態 | API | API | Microsoft Foundryのモデル | 自分の環境で動かすOSS(Apache 2.0) |
| モデル | jev-1.14.0(jev-latest) | GPT-6 Luna | Qwen3.5-9Bを元に学習 | Qwen3.5-2B-Baseを元に学習(19億パラメーター) |
| 質問の型 | noul / choice / score(画像向けにbox) | predicate / choice / score | noul / choice / score | noul / choice / score |
| 入力 | テキスト(画像は試験提供) | テキスト・画像 | テキストのみ | テキスト(--vision で画像も可) |
| 料金(入力100万トークン) | $0.042 | $0.10(キャッシュ利用時 $0.01) | $0.042(US・EUのData Zoneデプロイ) | 無料(実行環境の費用のみ) |
| 出力の料金 | 無料 | 無料 | 無料 | 無料 |
| 速度(公称) | 70〜500ms | Responses API経由のLunaより最大10倍速い | 中央値でGPT-6 Solの約35倍速い | 中央値 約115ms(RTX 3090での公式計測) |
速度はいずれも各社の公称値で、同じ条件で比べたものではありません。
Jev自体も更新されています。TypeSafe AIは、10月14日にJev 1.14を公開しました。jev-latest は jev-1.14.0 を指すようになり、jev-1.13.0 もしばらくは使えます。専用のヘッダーを付けると画像も入力でき、画像向けの新しい型 box も加わりました。ただし、画像の入力はまだ本番向けではない試験的な機能です。
OpenAIのDecisions APIは、10月22日にベータから正式版になりました。入力の料金はベータ時と同じ100万トークンあたり$0.10で、出力には料金がかかりません。キャッシュされた入力は$0.01です。1回のリクエストで、最大400問まで質問できます。
同じ10月22日に、Azure OpenAIでもDecisions APIが使えるようになりました。gpt-6-luna をデプロイしていれば、/openai/v1/decisions というエンドポイントで呼べます。認証は、APIキーとMicrosoft Entra IDの両方に対応しています。
Microsoftは、自社の判断モデル「Microsoft-Decision-1」も、10月9日にMicrosoft Foundryでプレビューとして公開しています。質問の型はJevと同じ noul / choice / score で、state と questions を送る形もJevとそろっています。入力の料金は、Jevと同じ100万トークンあたり$0.042です。Microsoftによると、中央値のレイテンシはGPT-6 Solより約35倍速いとされています。
AWSのStrands Labsは、10月1日にOSSの判断モデル「Strands Decider 2B」を公開しました。ライセンスはApache 2.0で、コードはGitHub、重みはHugging Faceで公開されています。pip install strands-decider で導入でき、手元のCPUやGPUで動かせます。公式の手順に沿って、自分のAWSアカウントにAmazon SageMakerのエンドポイントとして立てることもできます。
Jevの発表から約1か月で、選択肢がここまで増えました。テキストだけを安く判定するならJevかMicrosoft-Decision-1、画像も扱うならDecisions APIが候補になります。データを外部に出せない場合は、自分の環境で動かせるStrands Decider 2Bも選択肢です。料金や精度は今後も変わる可能性があるので、自社の業務データで比べてから選ぶのがおすすめです。
ミニワーク:Jevに任せたい業務を1つ書き出す
勉強会では、ここまでの内容を自分の業務に当てはめる、1分間のミニワークを行いました。読者の皆さんも、ぜひ試してみてください。
今は人やLLMが判断していて、Jevに任せたい作業を1つ思い浮かべます。そのうえで、次の4つの項目を埋めてみます。問い合わせの一次受けを例にすると、次のようになります。
| 設計項目 | 具体例 |
|---|---|
| 対象の業務 | 問い合わせ内容を読み、適切なチームに振り分ける |
| 渡すデータ(state) | 問い合わせの本文 |
| 設問(questions) | choice(ネットワーク / DB / アプリ / その他) |
| 確信度が低い場合 | 従来どおり、当番が手で振り分ける |
この4つがすんなり埋まる業務は、Jevに置き換えやすい候補です。迷ったら、前述の使い分けのフローに当てはめてみてください。
おわりに
Jevは、文章を書かずに判断と確率だけを返す、プログラム向けのモデルです。選択肢が決まった判断なら、速く安いので、スクリプトやジョブの中から毎回呼べます。一方で、できないことや苦手なこともあります。計算やしきい値の判定はプログラム、文章はLLM、迷ったら人か大型LLMに任せる、という分担が有効です。
発表後のアンケートでは、ありがたいことにたくさんの高評価をいただきました。「最新の技術なのに、すでに要点が整理されていた」「Jevに向く業務と、ルールやLLMに任せる業務の整理が分かりやすかった」といった声を頂戴し、大変嬉しく思っています。私自身も、身近な業務のどこにJevなどの判断特化AIを導入できるか、引き続き考えていこうと思います。
アジアクエストでは、今後もAIやクラウドに関する勉強会を開催していきます。connpassのアジアクエスト株式会社グループをフォローして、次回のイベントにもぜひご参加ください。
参考資料
- TypeSafe AI 公式サイト
- TypeSafe AI 公式ドキュメント
- Jev 1.14(TypeSafe AI ブログ)
- Jev 1.13 jaggedness(TypeSafe AI 公式ドキュメント)
- browser-use/jev-ultrafast(GitHub)
- jev-benchmarks(GitHub)
- jev-harness(GitHub)
- OpenAI「Decisions」ガイド
- OpenAI DevDay 2026 Recap
- OpenAI Decisions APIの正式版の発表
- Use the Azure OpenAI Decisions API(Microsoft Learn)
- Introducing Microsoft-Decision-1 in Microsoft Foundry(Microsoft Community Hub)
- Deploy and use Microsoft-Decision-1 in Microsoft Foundry(Microsoft Learn)
- Introducing Strands Decider 2B(Strands Agents)
- strands-labs/strands-decider(GitHub)